
你熟悉的AI通常把答案一小段一小段往外写。刚发布的Mercury 3走了另一条路:让多个位置同时修改、逐步收敛。厂商宣称它每秒能生成上千个词元,真正值得了解的,是这种速度从哪里来。
文|最极客
美国时间10月19日,Inception发布Mercury 3。厂商公告与Vercel当日的接入更新确认,这款扩散式语言模型已经通过API提供服务,而不只是放出一篇论文或概念演示。
新闻稿的发布时间是美国东部夏令时12时48分,对应北京时间10月20日凌晨0时48分。对中国读者来说,这是刚刚发生的一次模型发布。
Inception给出了一个醒目的数字:在NVIDIA GPU上的生成速度为每秒1068个词元。这里先保留“厂商公布”的前提,本文没有进行独立测速,也不能把这个数直接换成每秒1068个汉字。
答案不一定只能从左写到右
词元可以粗略理解成模型处理文字的小单位。一个单位可能对应一个词、词的一部分或其他文本片段,不同语言的切分方式也不同。
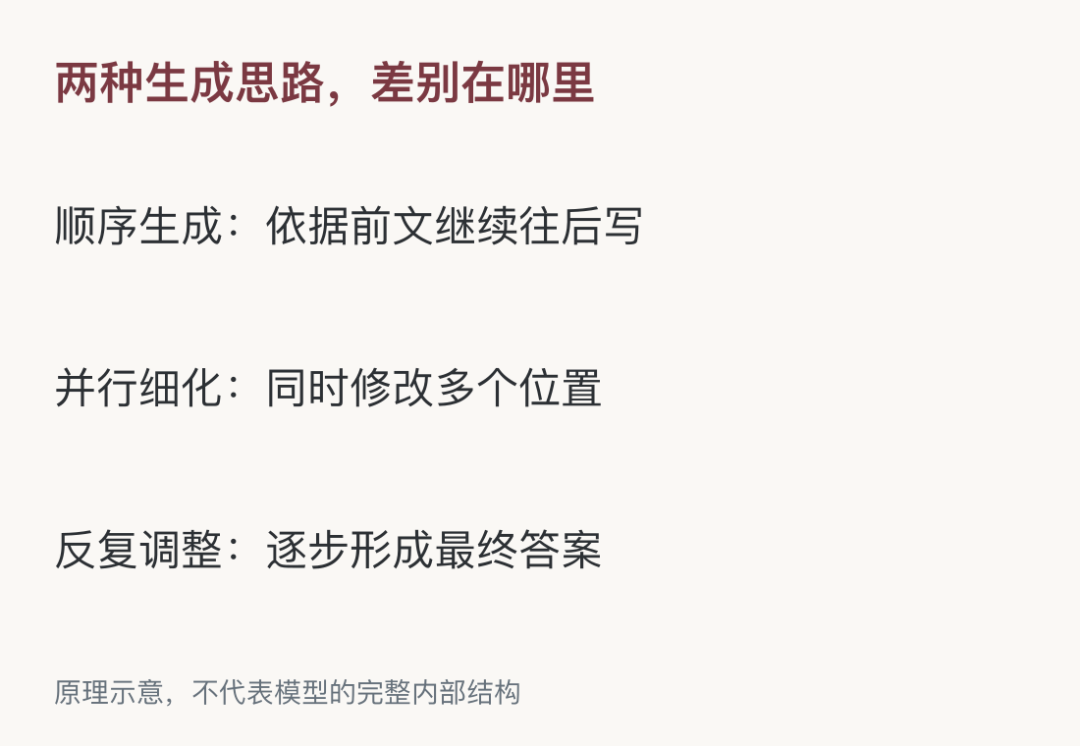
常见的自回归语言模型,会依据前面的内容继续预测后面的词元。你在聊天窗口里看到文字连续出现,背后往往就是这种逐步续写过程,尽管显示方式不完全等于内部计算方式。
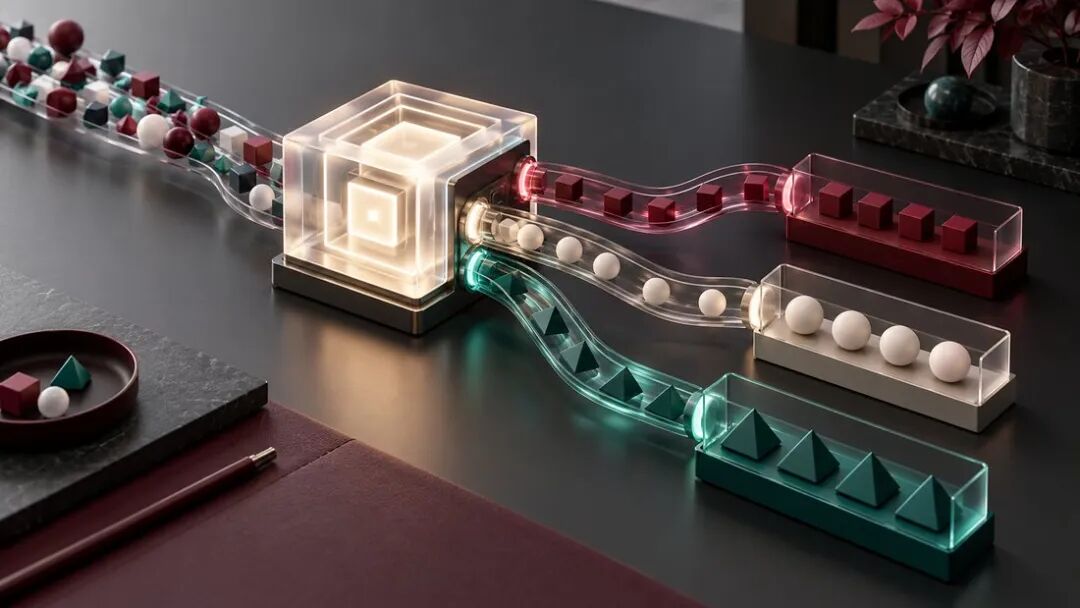
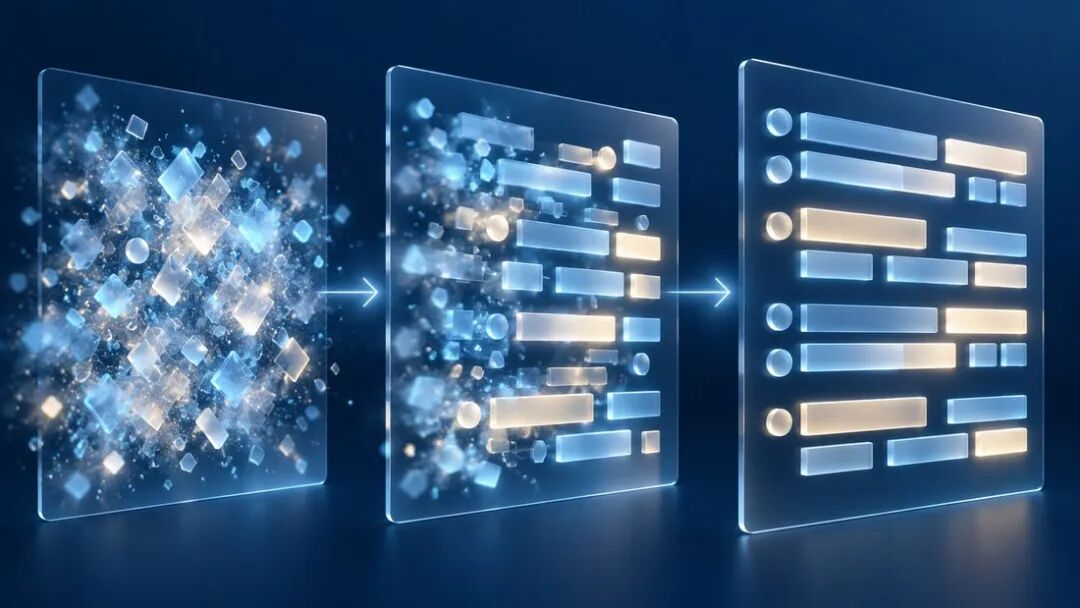
扩散式生成换了一个思路:不是只能等待前一个位置完成,再轮到下一个位置,而是让多个位置一起接受调整,经过若干轮细化形成输出。
可以用一道填空题作比方。顺序写作像先确定第一个空,再继续往后;并行细化则更像同时检查几个空,让它们彼此协调。这只是帮助理解的比喻,不是说模型真的在屏幕上拿橡皮擦修改文章。
Inception此前公布的技术说明,把这一过程描述为由粗到细地改进输出,神经网络可以同时修改多个词元。Mercury 3延续了这条路线,今天的新事实是新版本发布与服务开放,而不是扩散方法今天才被发明。
并行,为什么有机会更快
假设一项工作里,许多部分必须严格依次完成,那么后面的步骤就只能等待。若其中一些部分可以同时处理,就有机会减少串行等待;扩散语言模型尝试把这种并行空间用在文本生成上。
当然,并行不等于免费。每一轮修改仍然需要计算,模型也可能需要不止一轮才能得到合适答案。最终快多少,要看模型设计、推理系统、输出长度与运行硬件。
这与简单地要求模型“少想一点、少写一点”不是同一件事。前者改变生成组织方式,后者改变任务投入或输出规模;两者都可能影响等待时间,但不能混为一种突破。
也不应把“扩散”理解成先生成一张文字图片,再用识别软件转回文本。这里讨论的是语言模型对文本表示的生成过程,最终交给应用的仍然是文本。
上千词元,不等于一秒完成任务
聊天应用里至少有三种时间值得区分:多久开始看到第一段输出,开始输出后生成得多快,以及整个任务什么时候真正结束。
每秒生成多少词元,主要描述输出阶段的速度。如果前面还要读取长材料、检索网页或调用工具,用户感受到的总等待就会更长。
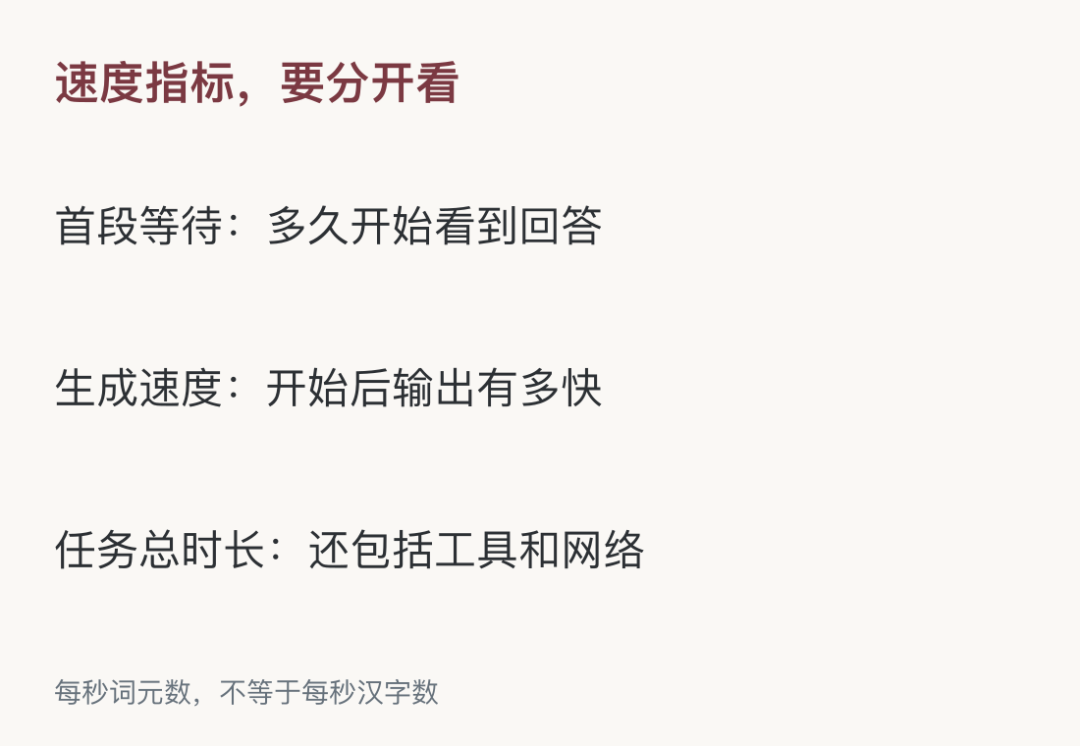
例如,让AI查几份文件再整理摘要,时间可能花在资料读取和检索上;让它在浏览器里完成一串操作,还需要等待页面加载。模型生成变快,只能减少其中相应的一部分。
因此,不能用“任务有十步”乘以一个厂商公布的倍数,就推导出整项工作一定快多少。正确的比较应该使用同一任务、相近设置,并检查最终交付是否合格。
Vercel的模型页面也把首词元延迟和输出吞吐率分别列出。对应用开发者,这个区分很实际:一个模型可以输出很快,却不一定最早开始回答;两项指标需要一起看。
它可能用在哪里
Mercury 3发布时支持百万词元上下文,并提供API接入。更长上下文意味着一次请求可以容纳更多材料,但并不保证模型能准确使用其中每一个细节。
实时问答、学习提示和客服辅助,是容易理解的使用方向。用户提出问题后,希望尽快得到有用反馈;等待太久,会打断对话节奏。
另一类是反复调用模型的工作流。一次任务可能先整理问题,再处理资料,最后生成结果。如果每一轮都要等待模型输出,那么多轮累计的延迟就值得优化。
这只是应用逻辑的解释,不代表所有这些场景都已经获得独立验证。发布公告中列出的合作方经验,也应视作公告提供的案例,而非本文实测成绩。
使用方式上,它更接近开发者可接入的模型服务,而不是一台需要购买的新硬件。Vercel已公布接入入口;实际调用还需检查账号权限、当前定价与数据处理条款。
快之外,还要检查什么
如果你要判断它是否适合自己的产品,可以准备一组固定问题,覆盖短回答、长材料和需要核实的信息。分别记录开始响应时间、完成时间、错误和人工修改量。
尤其不要只比较最终输出的字数。一个回答写得短、漏掉要求,看起来当然更快;速度比较只有在任务完成质量相近时才有意义。
目前可以确认的是:Mercury 3已经发布,并有平台提供接入。厂商的速度与能力比较需要结合测试条件理解,不能直接扩展成“全面超过所有主流模型”。
这次发布带来的知识增量,是AI写答案并不只有逐个续写这一条路。并行细化提供了另一种实现方式,能否把它变成更好用的应用,还要同时看质量、等待和实际任务成本。
微信扫一扫,分享到朋友圈