
在 AI 界普遍信奉"参数越大、能力越强"的今天,一家伦敦初创公司用一场"以小博大"的实验,让"大就是好"的叙事出现了裂缝。
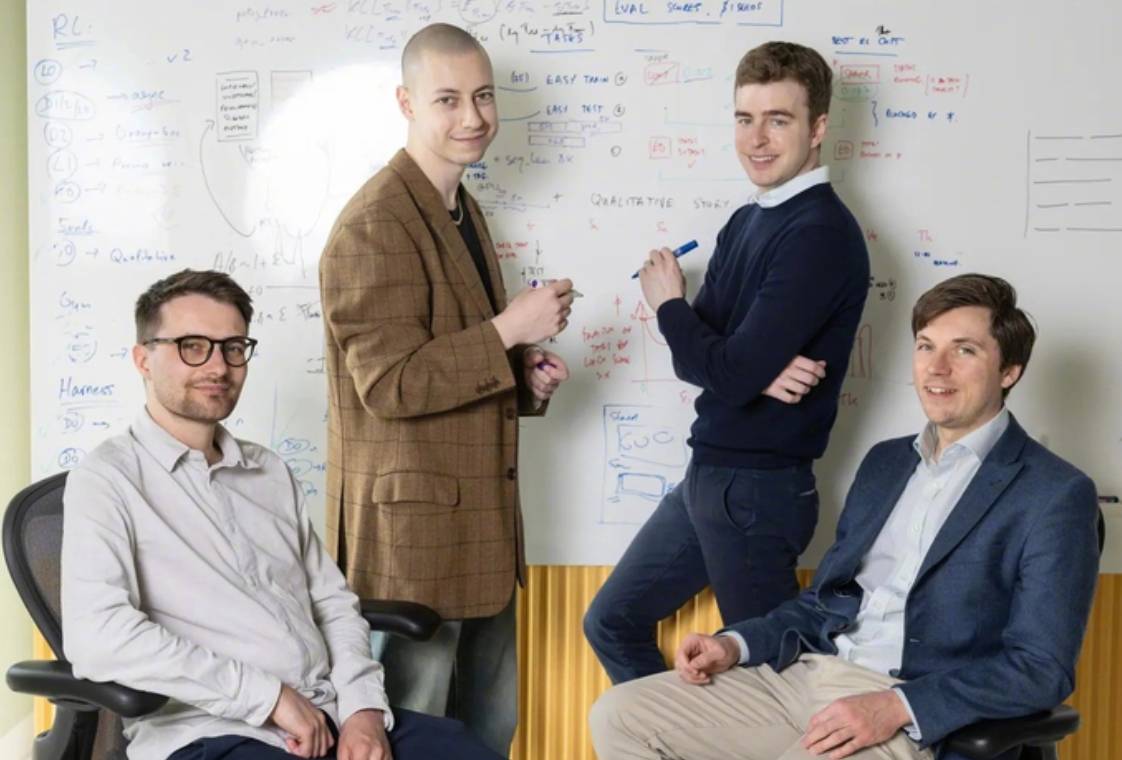
据 IT 之家 8 月 23 日消息,由前 Google DeepMind 员工创立的 AI 实验室 Inherent,正式推出其 AI 智能体 Faraday。这家公司宣称,在"事先不知道答案的情况下,自主复现已发表科学论文中的研究结果"这一特定任务上,Faraday 击败了规模大得多的 Anthropic Claude Opus 4.8 与 OpenAI GPT-5.5。
真正让人意外的是底层模型的体量:Faraday 背后依赖的是仅拥有 270 亿参数的开源模型 Qwen 3.6,而它的两个对手,都是动辄数千亿参数级别的前沿系统。用如此小的模型,在如此硬核的任务上跑赢巨头,这在过去几乎难以想象。
不过,Inherent 联合创始人兼首席科学家 Edward Hughes 反复强调,击败对手并非重点,"真正重要的是我们构建这个系统的方式"。Faraday 的能力,主要不来自模型本身,而来自一套以强化学习为核心的训练方法——不是把明确规则塞给 AI,而是根据最终结果对智能体的行为进行奖励,让它在试错中逐步学会"更有效的行动"。
这一思路背后,藏着 Inherent 更大的野心:打造真正的"AI 科学家",而不仅仅是复现论文的工具。公司甚至给 Faraday 设定了更难量化的目标——具备"研究品味",即能够判断哪些实验值得做、应该如何设计实验。这正是人类科学家最难被替代的部分,也是当前大模型普遍欠缺的能力。
从产业视角看,Faraday 的出现传递出两个值得关注的方向。其一,算法效率与训练方法的创新,正在成为比"堆参数"更具性价比的突围路径,这对算力紧张、成本敏感的中小团队尤其具有启发意义。其二,"AI 科学家"正在从概念走向可验证的成果,若复现能力能够泛化到多个学科,科研范式的变革或许会比预想中来得更早。
当然,眼下 Faraday 的胜利仍限定在"复现论文"这一窄任务上,距离真正"发现新知识"还有很长的路。Hughes 本人也坦言,论文复现只是人类博士生的入门功课。但正如他所说:"很多博士生实际上都是从这件事开始的。"若 AI 也能从这一步扎实起步,未来可期。
这家目前仅约 12 名员工、全员线下办公于伦敦国王十字区的公司,计划年底前扩至 20 至 25 人。在巨头林立的 AI 竞赛里,Inherent 用一场漂亮的局部胜利证明:创新,有时并不靠"大",而靠"对"。
微信扫一扫,分享到朋友圈