
摘要:医生看病不是看一眼症状就按答案键,而是边问、边检查、边修正判断。微软10月22日发表的新研究,让AI也参加这种“分步诊断考试”;成绩醒目,但考场还不是医院。

医生看病不是看一眼症状就按答案键,而是边问、边检查、边修正判断。微软10月22日发表的新研究,让AI也参加这种“分步诊断考试”;成绩醒目,但考场还不是医院。
文|最极客
有些病情一开始并不“像教科书”:一个症状可能对应几种原因,医生得先问清楚,再决定要不要做检查。微软的新研究把这段过程搬进AI测试:系统不能直接看完整答案,而要像接诊一样,一步步请求信息、选择检查,再根据新线索调整判断。
在这套考题里,病例信息不会一开始全部摊开。系统需要主动请求病史或检查结果,评测程序再按规则给出相应线索;它必须为下一步花时间和成本,而不是把所有化验单都当成免费的提示卡。
微软10月22日宣布,相关论文当天发表于《Science》。研究介绍了一个名为SDBench的分步诊断基准,以及诊断协调系统MAI-DxO。简单说,SDBench像一套模拟考题,MAI-DxO则像一个会安排“下一步该问什么”的AI团队。
时间线也要交代清楚:这项研究并非本周才首次公开,作者团队在2025年6月已把早期版本放上arXiv。10月22日的新进展,是经过同行评审的论文正式发表于《Science》,并在公司公布的研究结果中增加了较常见急诊病例的评估;它是研究更新,不是突然冒出的临床产品。
这项消息值得看,不是因为“AI医生已经来了”,而是因为它把测验方式往真实看诊流程推进了一步。过去不少AI医学测试,会把整理好的病历一次性递给模型,再让它选一个病名;这次则让系统面对不完整信息,自己决定下一步。
像侦探一样,一条线索一条线索找
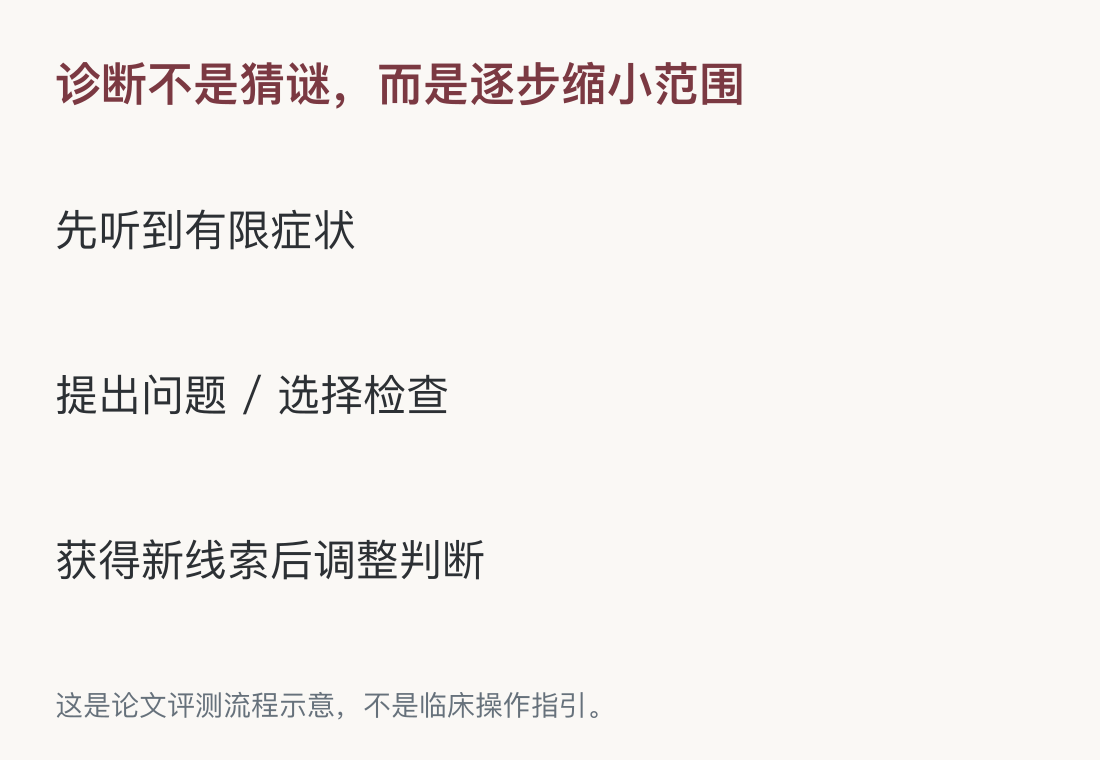
MAI-DxO不是一个模型独自作答的简单问答框。微软描述的系统会协调多个AI角色,模拟问诊、提出检查建议,并围绕可能诊断进行推理;它还要考虑检查的成本,而不是把所有检查都点一遍。
这有点像侦探办案:先听到有限线索,再决定问谁、查什么,得到新信息后重新判断。类比只是为了说明“分步决策”,并不表示AI真的理解患者处境,更不意味着研究者让它在医院里接触了患者。
测试集包含304个来自《新英格兰医学杂志》病例讨论的复杂病例,以及一组来自MIMIC-IV-ED数据库的急诊病例。后者让研究人员能观察系统面对较常见急诊情形时的表现;两类考题都以文本交互方式模拟,不能等同于把一套AI放进诊室。
在复杂病例测试中,微软报告MAI-DxO的诊断准确率约83%,参与比较的全科及内科医生使用教科书和互联网资料时约36%;医生不使用外部资料时约22%。在急诊病例上,系统约80%,医生约47%。这些数字来自不同病例集,不能混在一起理解成“所有看病场景都提高了某个固定比例”。
83%听起来很高,考场条件同样重要
最容易被标题省掉的一句是:这是一场历史病例的模拟测试。系统读到的是整理成文字的病情线索,不是一个会停顿、漏说信息、表情痛苦,或需要现场检查的真实患者。
对照组也不是“所有医生”。复杂病例通常可能由专科医生或多学科团队处理;微软与媒体报道都说明,这次比较的医生主要是单独工作的全科医生或内科医生,并没有把专家团队放进同一场对照考试。
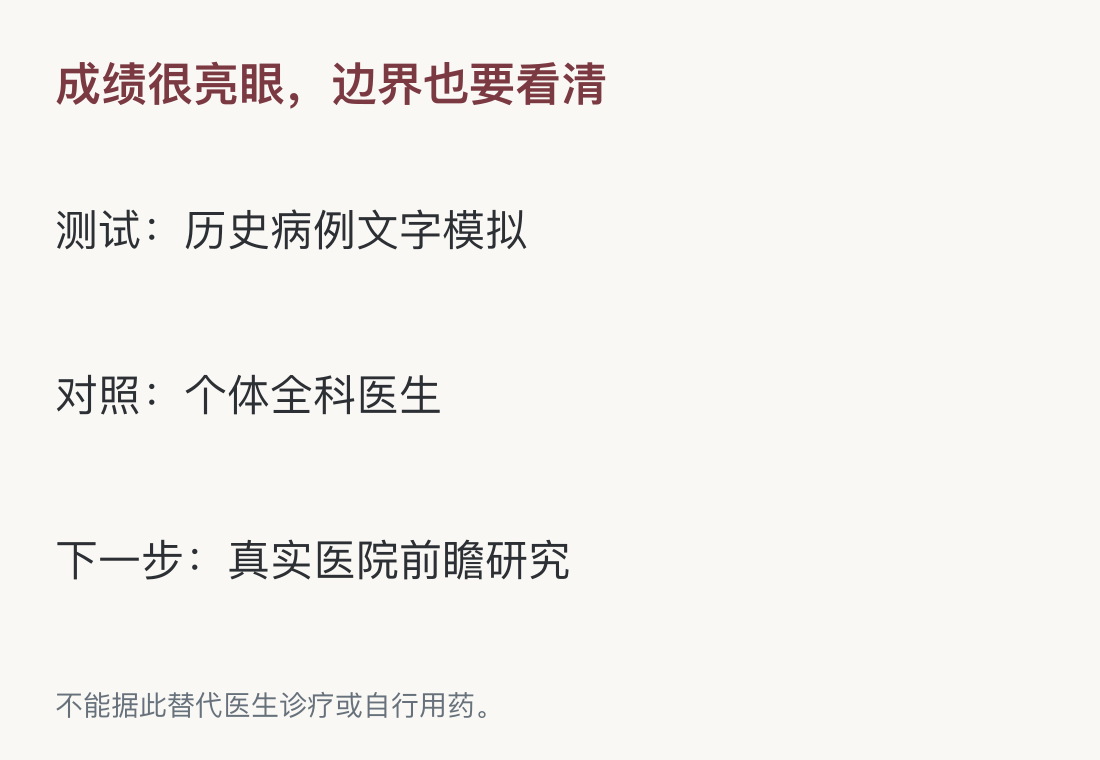
因此,准确率的差距说明系统在这套题目和规则下表现突出,不足以证明它在医院里比医生更安全、更有效。病例测试关注最终诊断是否与既有答案一致,也无法完整呈现沟通、体检、患者偏好、急救优先级等真实医疗环节。
另一个值得注意的点是“检查成本”。研究同时考察系统选择问题和检查的方式;微软称,加入成本限制后仍能保持一定准确率。但成本模型、检查价格和医疗流程会随医院、地区而变化,不能据此直接推算普通患者能省多少钱。
它离真正的诊室,还隔着临床验证
对患者来说,AI辅助诊断最有希望的价值,不一定是机器直接告诉你“得了什么病”,而是帮助医生更快整理复杂信息、提醒可能遗漏的线索,或为资源紧张的地方提供额外参考。前提是这些建议在真实工作流里有用,而且不会增加新的误诊风险。
微软表示,下一步计划与波士顿一家医院开展前瞻性临床研究,在医院环境中比较AI评估与医生判断。注意“计划研究”不等于已经验证;真正有说服力的结果,要看研究对象、执行流程、错误类型、对患者结局的影响,以及不同医院能否复现。
如果AI把一种罕见病排到很前面,却漏掉需要立刻处理的常见急症,单看“猜中最终病名”的总分就不够。医疗系统还要知道什么时候应该追问、什么时候应请医生接手、什么时候不能把不确定说成确定。
这次研究把AI医学从“背答案”推向“边问边判断”,是可核实的进展;但它目前证明的是一项模拟评测成绩,而不是AI可以独立看病。对普通人而言,暂时最实用的结论很简单:看诊仍找医生,AI研究值得关注,但不要把论文排行榜当成健康建议。
微信扫一扫,分享到朋友圈