
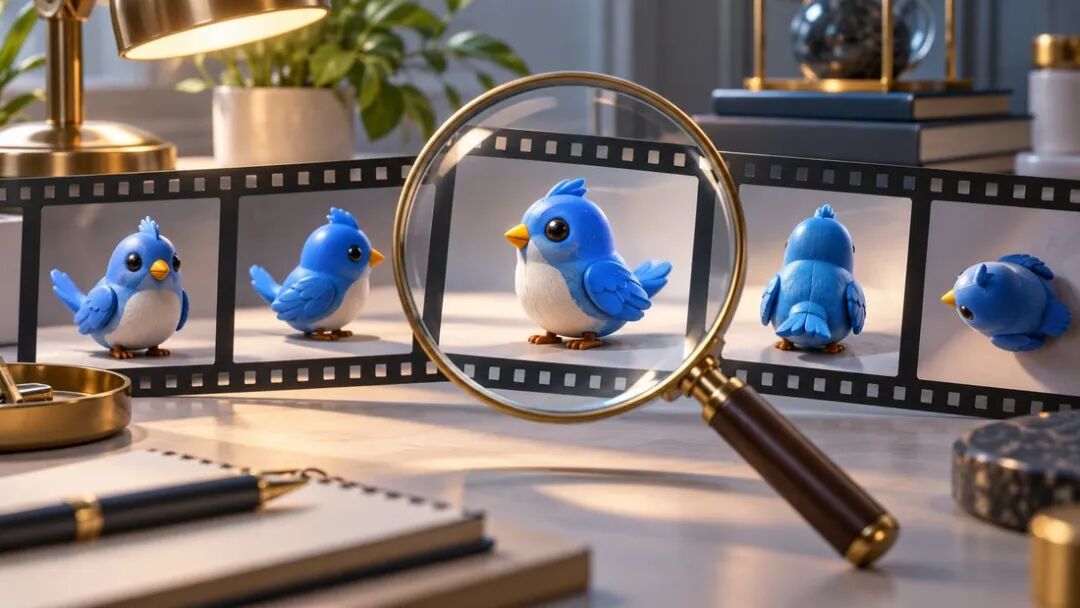
看见一只鸟,不等于能在镜头移动后认出还是它。Elorian发布的Glimpse把注意力放在这类问题上:遇到不确定的画面,重新放大、抽帧、比较,再尝试回答发生了什么。
文|最极客
10月16日,Elorian推出首个模型Glimpse,定位为视觉思考模型,并以研究预览形式提供访问。它想解决的,是AI看图、看视频时一个常见的困难:认出了物体,却没有跟上物体之间的关系和变化。
比如,画面中先后出现两只相似的小鸟。摄像机转过一个角度后,哪只还是刚才那只?这是一个身份跟踪问题,不能只靠回答“画面里有鸟”解决。
再比如,机械臂靠近杯子、夹住杯子、把杯子放到桌面,分别意味着不同的任务阶段。仅凭某一帧看到夹爪与杯子重叠,不能确定抓取已经成功。
这些是帮助理解的例子,不是我们实际运行模型得到的测试结果。
把“再看一眼”放进推理过程
Elorian的核心主张,是让模型在思考过程中继续查阅视觉材料。它可以调用工具裁剪图像、选择视频帧,或运行代码辅助检查,而不是只依靠最初的一次观察。
可以把这种工作方式理解为一个视觉草稿区:第一次看全局,发现问题后检查局部,再把检查结果用于修改判断。这个比喻描述的是处理过程,不表示模型像人一样拥有主观视觉体验。
为什么这件事有用?一张复杂的图里,真正决定答案的细节可能非常小。先识别整体,再针对问题放大某个区域,有机会减少漏看。
视频的问题又多一层。一个动作可能只发生在很短的时间里;抽取的画面如果恰好跳过关键时刻,模型就可能把两个不同的事件连接成一个错误故事。
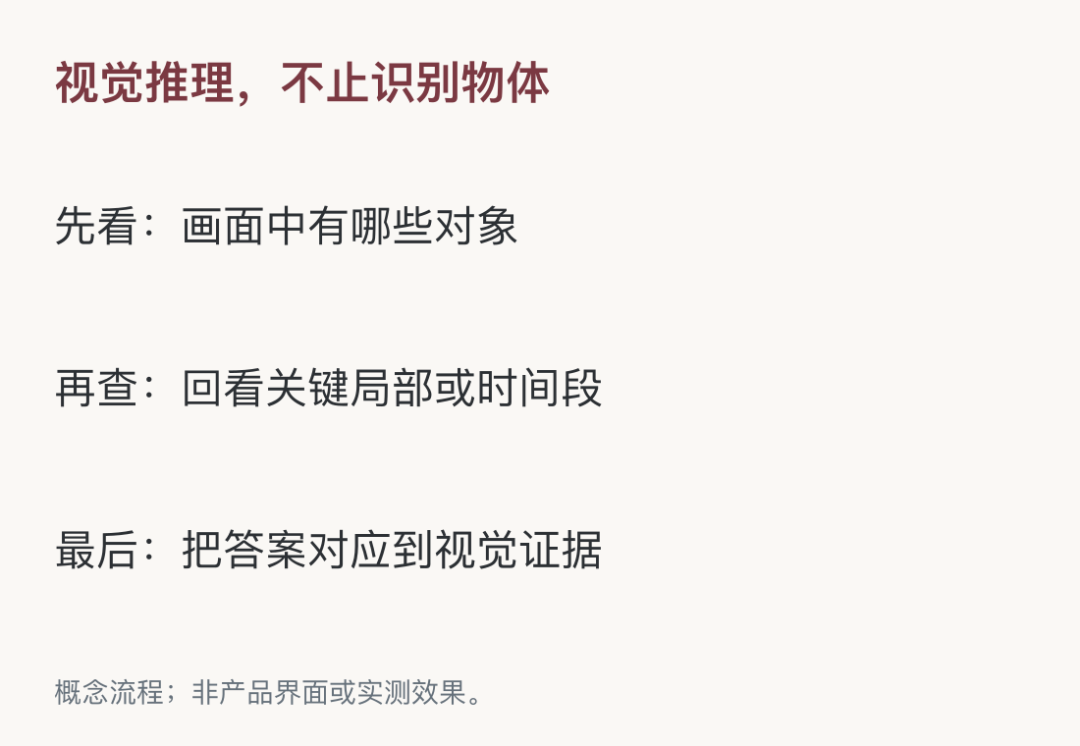
因此,模型需要决定哪里值得再看,而不仅是生成一段更长的解释。解释写得流畅,并不能补回没有观察到的证据。
从厂商材料里,能确认什么?
官方发布页介绍了在推理过程中回查图像和视频的机制,也展示了记录下来的模型输出。与此同时,页面明确区分了部分记录输出与用于说明问题的参考答案。
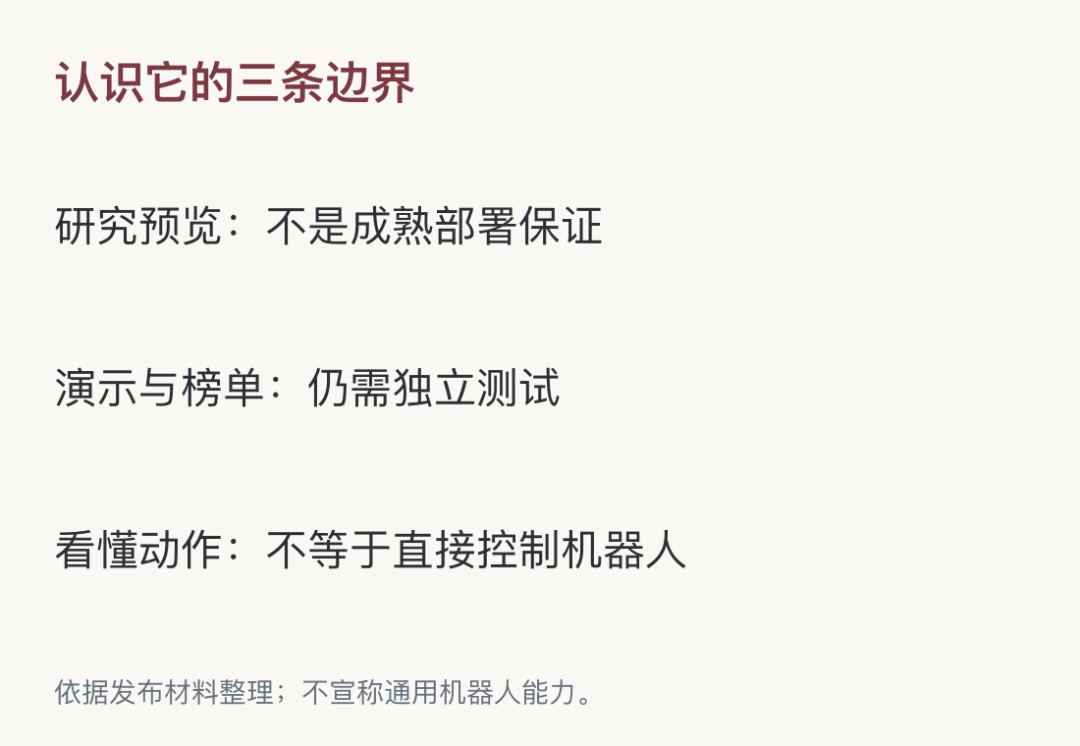
这种区分很重要。页面展示了一道题以及正确解释,并不自动证明那段解释由模型独立生成,更不能说明它在所有类似题目上都能答对。
我们阅读的是发布材料,没有独立运行Glimpse,也没有把网页中的示例视频逐一做完整播放测试。因此,本文介绍产品机制与公开证据,不给出自己的成功率或使用体验。
公司提供了一组多模态基准比较,但这些仍是公司报告的结果。不同模型的工具、思考设置和测试任务会影响结果,不能从某几项领先直接推导出“全面超过所有模型”。
对于普通读者,理解这个边界,比记住一个榜单名次更有价值。它是一款值得观察的新模型,不是一份视觉理解已经解决的证明。
哪些工作可能用得上?
一个自然方向,是给视频材料做更细的事件标注。不是只写“人在工作”,而是尽量标明谁在什么时候完成了什么动作。
这对整理素材、查找片段或制作训练数据可能有帮助。但是否真正减少人工工作,需要看标注是否准确、时间位置是否能核对,以及纠错要花多少时间。
另一个方向,是回答图表里的具体问题。例如,某条曲线在哪个区间发生变化,答案对应图中的哪个位置。模型应把结论指回可见证据,而不是只输出一个看起来专业的数字。
如果画面本身缺少刻度、单位或清晰细节,放大也未必能得到答案。把模糊信息解释得很确定,仍然是错误;正确做法可能是要求更清晰的原图。
还有机器人视频理解。识别某一步是否完成,可以为规划和检查提供信息,但它与直接驱动电机是两回事。
真正的机器人控制还涉及动作策略、硬件约束和安全机制。不能因为一个模型看懂了抓取片段,就把它写成已经能够接管任意机器人。
怎么试,才不会被漂亮演示带偏?
如果有访问权限,可以先选择一小组允许上传、答案明确的图片或视频。不要从无法核对的开放问题开始,而是先问对象数量、事件顺序或图表中的具体关系。
例如,准备一个玩具被遮挡后重新出现的短片,并事先记录真实数量。让模型回答时同时指出证据位置,再由人回看原片验证。
这是一种建议的测试设计,不是Glimpse的官方标准评测。它的目的,是把“回答听起来不错”变成“答案是否符合素材”。
同一任务也应交给现有工具,用相同材料比较。记录错误类型、总耗时和完整调用成本,而不是只比较一次回答的字数或单个价格数字。
如果用于客户素材,还需要先处理授权和隐私。研究预览的可用性、账号权限以及数据处理条件,都应以实际访问时的服务说明为准。
Glimpse带来的新鲜感,在于让视觉AI的思考过程更靠近证据:不确定,就重新检查。它能否把这种机制稳定地转化为更少的错误,还要靠真实任务中的验证。
微信扫一扫,分享到朋友圈